 AIGC.promo
OpenAI 一夜甩出 700 篇数学论文:数学史的高光,还是学术界的"灾难"?
2026-10-06,OpenAI 用未公开的闭源模型一次性发布 700+ 篇 AI 生成数学论文。学界两极分化:有人称数学史最重大时刻,有人担心职业生涯被"抢先"。
2026 年 10 月 6 日,ChatGPT 的开发商 OpenAI 在 GitHub 上一次性发布了 700 多篇完全由 AI 生成的数学预印本,全部基于其未公开的闭源模型。瞬间,整个学术界"炸了锅"(up in arms)。这不但重新定义了 AI 在基础科学前沿的能力边界,也让无数研究者陷入惊叹与焦虑交织的阵痛。
试想一下:你和团队苦心钻研多年的课题,在一夜之间被 AI 彻底解开,还一下子公开了 700 多篇——这不是科幻,而是刚在数学界发生的地震。当 AI 开始批量"攻克"数学难题,一个持续了几百年的学科,正被推到前所未有的十字路口。
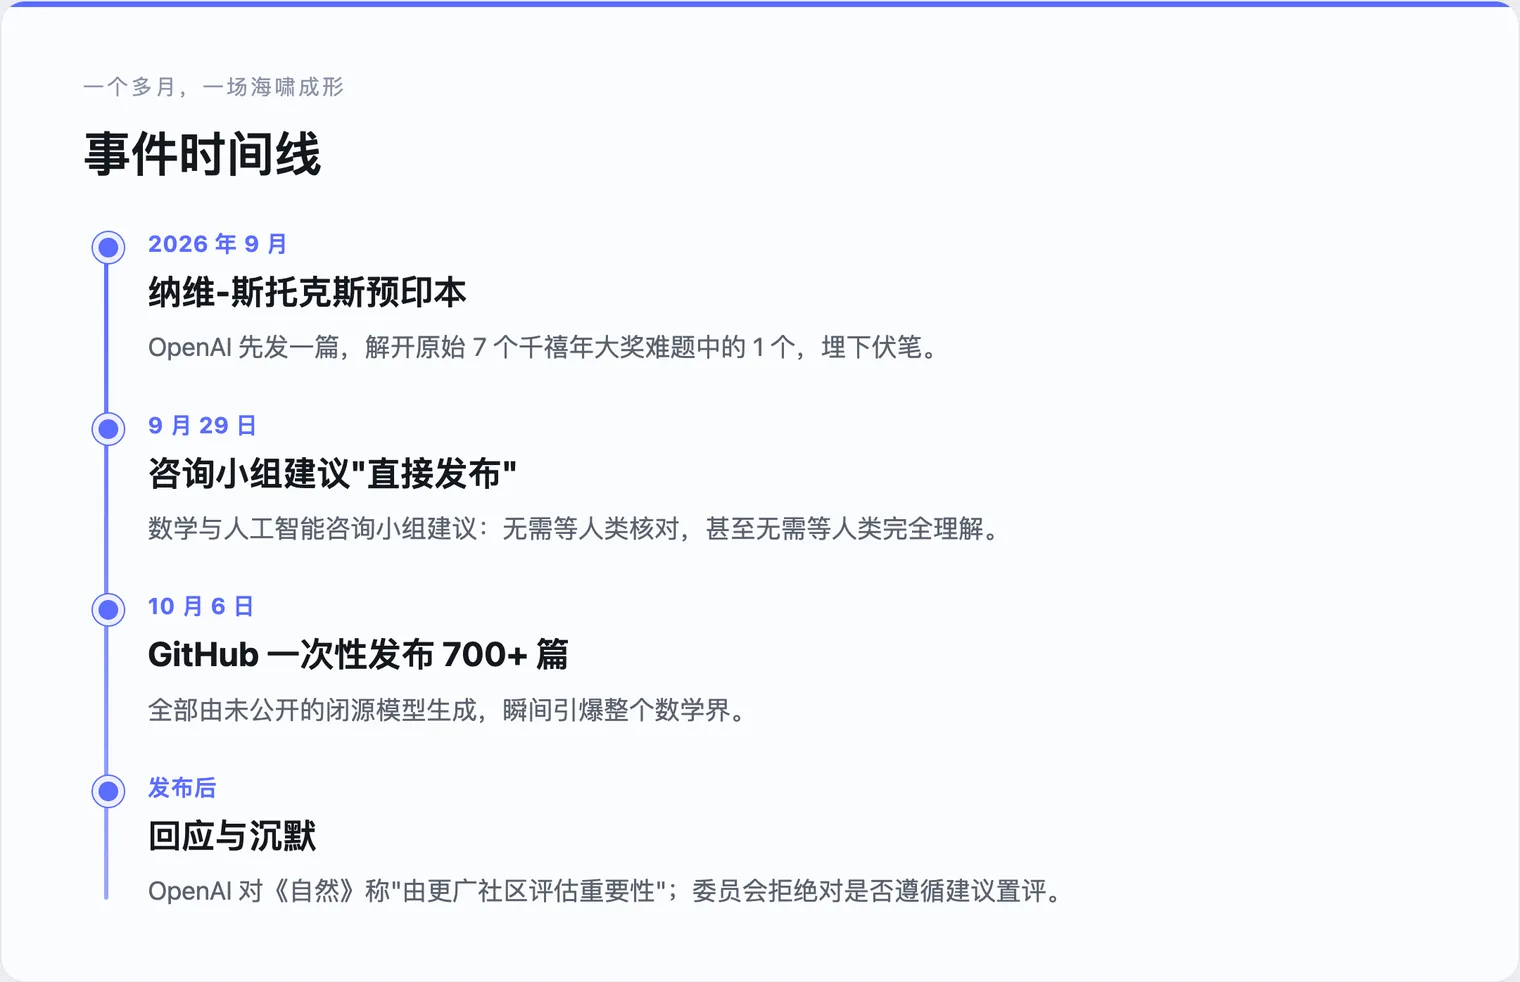
图注:从 9 月的一纸纳维-斯托克斯预印本,到 9 月 29 日咨询小组"直接发布"的建议,再到 10 月 6 日 700 篇齐发——这场海啸只用了一个多月就成形。
一、700 篇齐发,数学界遭遇"规模化冲击"
最先冲击学界的,是数量和速度。对习惯精雕细琢、漫长推理与同行评审的数学家而言,"批量生成"的产出方式简直不可思议。康涅狄格大学数学家 Alvaro Lozano-Robledo 在 X 上直言:一次性发这么多"令人震撼(staggering)"。甚至有物理学家戏称这是一场"垃圾信息末日 / 论文大爆炸(slopocalypse)"——即便这些推导最终可能被证明在形式上完全正确。
当闭源模型在暗处批量"撞车"人类数年的研究成果,比技术震撼更早到来的,是成果归属与职业生存的现实危机。
二、两极分化:数学史最重大时刻 vs 研究者的"悲剧"
面对这场海啸,学界态度截然相反。
一方面,有人为长期难题的突破欢呼。Anthropic 的数学家 Levent Alpöge 说:"我们今天应该把这些悲伤放在一边。这显然是数学史上最重大的时刻,因为它展示了这项技术以多惊人的速度变得对数学家有用。"但他也承认,对那些成果被 OpenAI 挤占的数学家,确实发生了一些"悲惨的故事"。
另一方面,许多研究者愤怒而沮丧:他们耗费多年心血的项目,被一家商业公司的未公开模型瞬间抢先(scooped)。在传统学术体系里,优先权与首发权是青年学者拿教职、申经费、立地位的生命线——当闭源模型在暗处批量撞车,触发的是对职业生存的底层焦虑。
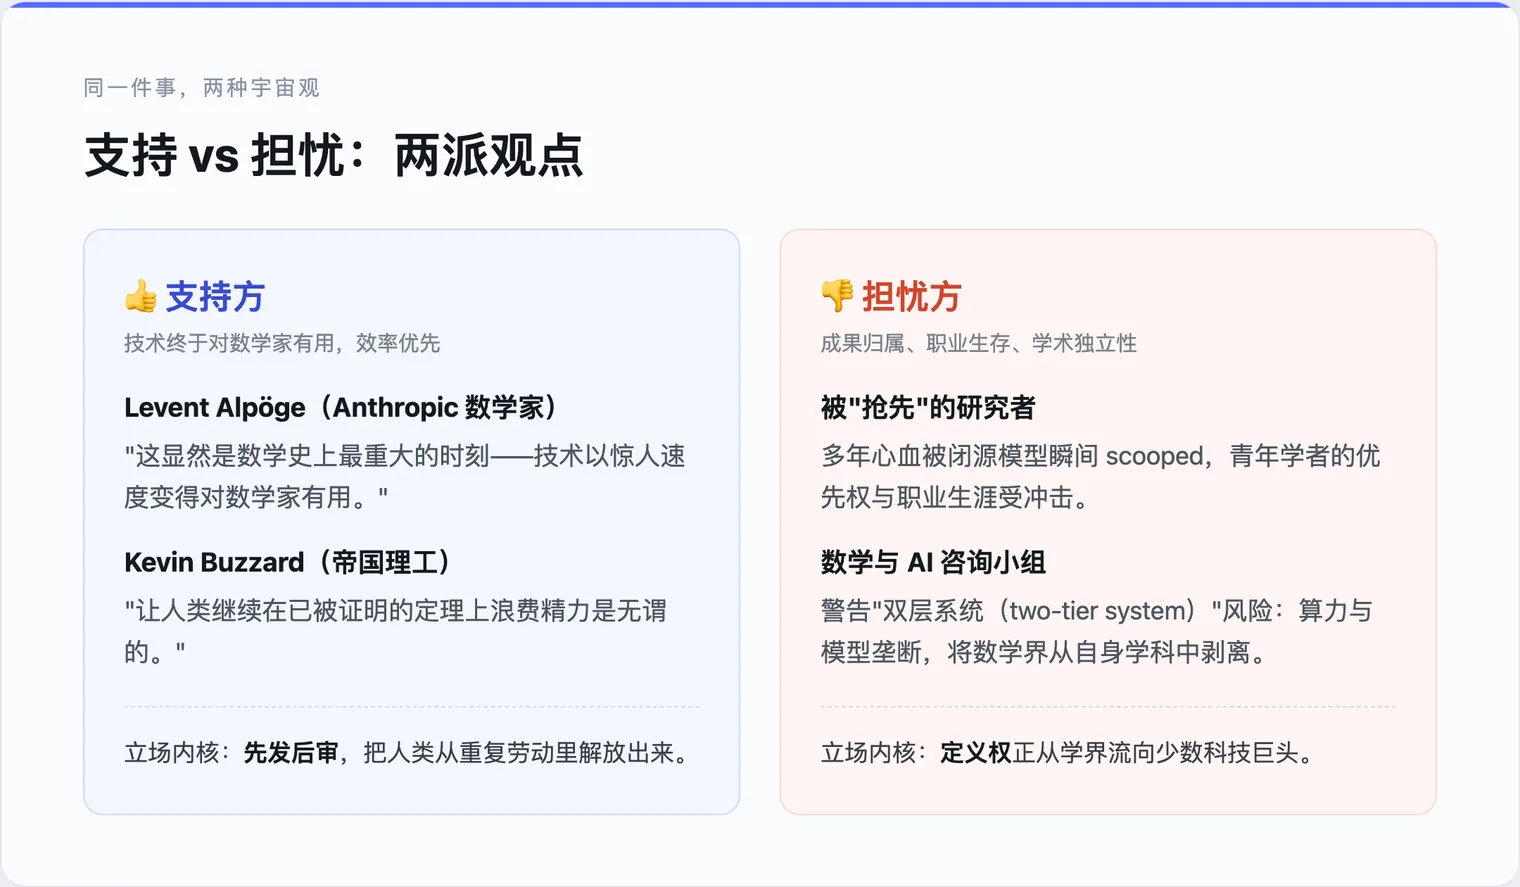
图注:支持方看重"技术终于对数学家有用"与"别在已证定理上浪费人力";担忧方则盯着"职业生涯被抢先"与"双层系统"的风险。
三、百年难题被破,但千禧年大奖难题还稳着?
这批预印本到底触到了多深?AI 的触角已经深入数学最核心的腹地。
需要注意:这 700 多篇并不包含克雷数学研究所剩余 5 个"千禧年大奖难题"的直接解答。背景是——OpenAI 曾于 9 月发过一篇关于纳维-斯托克斯方程的预印本,解开了原始 7 个难题中的 1 个;另 1 个早在 21 世纪初就被数学家解出。但这次的论文广泛渗透到相关领域,比如复代数变种上的霍奇猜想、关于素数统计的黎曼猜想。
OpenAI 发言人对《自然》杂志保持了谨慎:"我们将由更广泛的社区来评估[它们的]重要性。"此外,OpenAI 声称部分被攻克的问题历史已超百年,横跨抽象代数、数学物理、量子算法、微分几何等多个复杂分支。
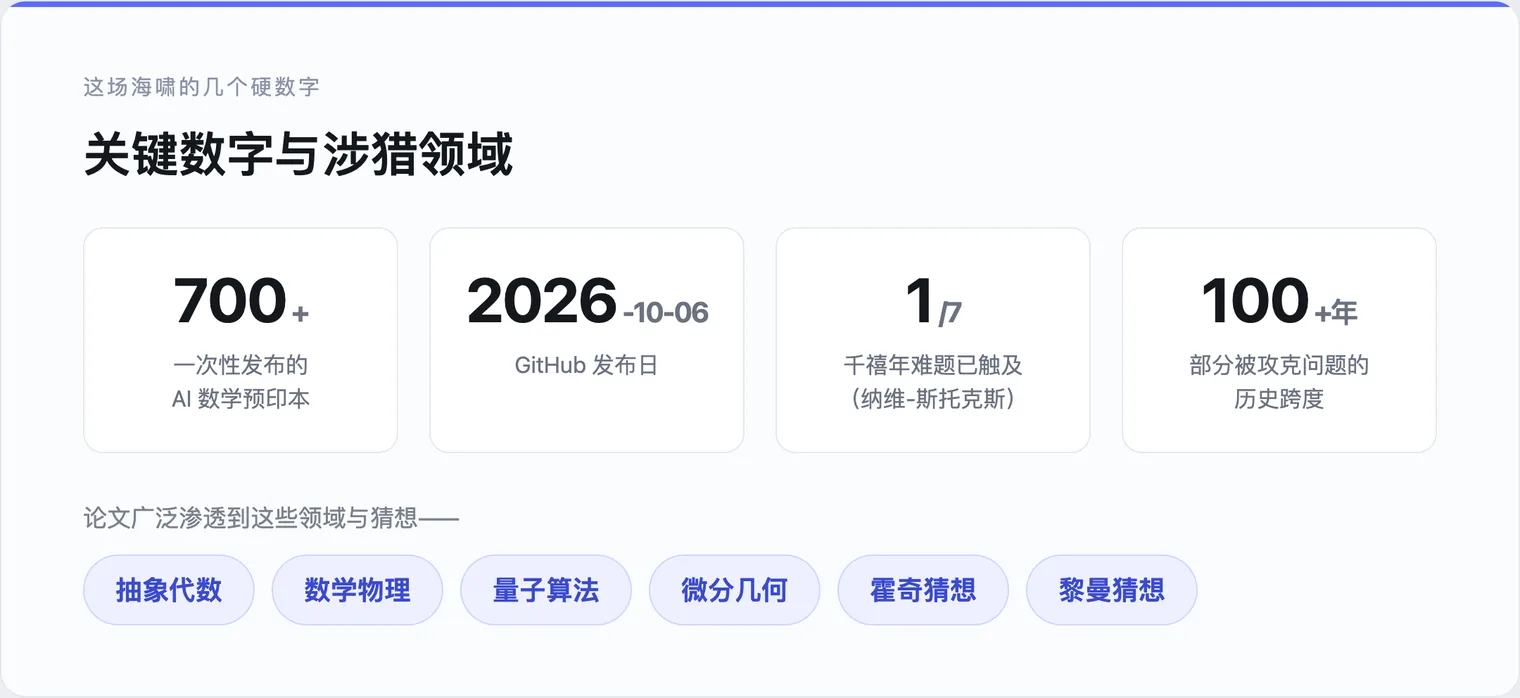
图注:700+ 篇预印本、发布日、已触及 1/7 千禧年难题、部分问题超百年;论文渗透到抽象代数、数学物理、量子算法、微分几何,以及霍奇、黎曼两大猜想。
四、先发后审的争议:"让人类重复证明已知定理是浪费时间"
在发布流程上,OpenAI 挑动了学术界最敏感的审核神经。
发布前的几周,OpenAI 征求了一个名为"数学与人工智能咨询小组"的特别委员会的意见,并遵循其 9 月 29 日 的建议:直接发布研究结果,无需等待人类核对,甚至无需等待其被人类完全理解。
这里有个深刻的认识论悖论:AI 正以超越人类验证与理解速度的效率,批量产出形式正确的证明。当数学证明在未经人类"完全理解"的情况下被直接抛入公域,数学这门自古以来强调理性洞察的学科,是否正在退化为一种只能被动接受的"黑箱逻辑"?
对此,伦敦帝国理工的数学家 Kevin Buzzard 仍对直接发布表示支持:"让人类继续在已经被证明的定理上浪费精力是无谓的。"
五、"双层系统"危机:商业巨头是否在剥离传统学术界?
技术辉煌的背后,是商业 AI 实验室与传统学界之间深层的权力与资源不对等。
咨询小组警告:AI 实验室使用未公开的内部闭源模型做科研,可能制造一种"双层系统(two-tier system)"——拥有算力和模型的一方,发展速度将远远抛离该领域的普通研究者,进而"有效地将数学界从其自身的学科中剥离和异化"。
面对垄断话语权的质疑,OpenAI 发言人回应《自然》:公司的目标是"为数学家和科学家提供工具",并补充道会"针对所有科学领域的前沿难题来评估和开发我们的模型"。但当《自然》联系委员会成员,询问 OpenAI 是否确实遵循了建议时,他们均拒绝置评。当最顶尖的科研工具被少数科技巨头垄断,科学研究的独立性与传统学界的定义权正面临空前考验。
结语:数学的未来,由谁定义?
OpenAI 一次性公开 700 篇 AI 数学论文,既向世界展现了人工智能在基础科学前沿的惊人爆发力,也彻底撕开了技术剧变下学术伦理、成果归属与学科生态的剧烈阵痛。
当商业巨头的闭源模型可以批量解开人类积累百年的智慧谜题,一个终极问题摆在了所有人面前:在未来的科学探索中,人类数学家究竟会成为这些强大 AI 工具的掌舵人,还是会被远远甩在身后、沦为只能被动接收机器指令的旁观者?