 AIGC.promo
帕累托前沿:AI 在变便宜,但最强的 AI 在变贵
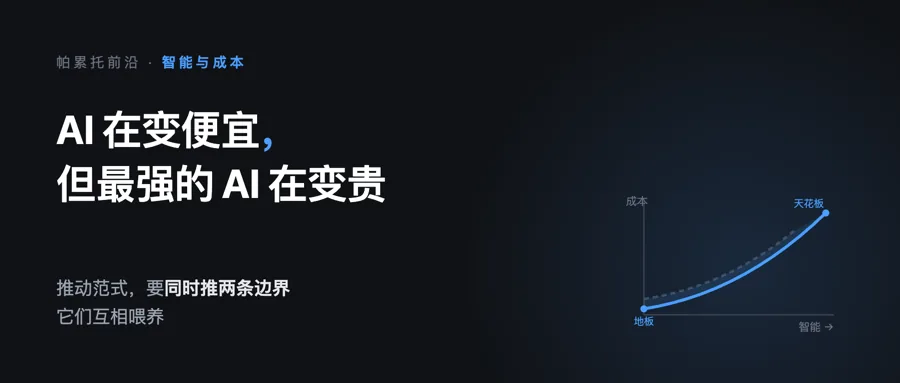
前沿模型的价格每年降 5–10 倍,但跑最强模型的成本每年涨 3–18 倍。这两个都是真的。
先摆一组互相打架的数字,它们都是真的:
- 达到同等智能水平,前沿模型的价格每年下降 5–10 倍
- 但跑最强模型的成本,在 GPQA-Diamond、SWE-bench 这类基准上每年上涨 3–18 倍
AI 在变便宜,同时最强的 AI 在变贵。
这不是数据出错,而是我们讨论 AI 进步时用错了模型——我们习惯用"更聪明了""更便宜了"这种单维度的说法,但真实发生的事情发生在一条线上,这条线叫帕累托前沿。
理解它,你才能分清:哪些进展是真推进,哪些只是换了个位置。
一、什么是帕累托前沿
把"智能"放在横轴,"成本"放在纵轴,把所有能买到的模型画成点,会得到一片散点。
其中有一批点很特别:在不增加成本的前提下,你已经找不到比它更聪明的了。把这些点连起来,就是帕累托前沿。
这条线把平面切成三块:
| 区域 | 含义 | 判断 |
|---|---|---|
| 线上 | 钱花到了极致,没浪费 | 这是"当前最优解",选模型应该在线上选 |
| 线内 | 同样的钱能买到更聪明的 | 有浪费。可能是工程没做好,也可能是在为延迟、合规等别的维度付溢价 |
| 线外 | 当前技术做不到 | 这是机会区——所有"理论上很想要但算不过账"的应用都躺在这里 |
关于"线内"要多说一句:落在前沿里面,不一定等于做错了。延迟、数据安全、稳定性、多模态,都是要付费的维度。前沿只是"智能—成本"这一个截面的最优,不是全部。
真正值得盯的,是线外那块空白。
二、两种进步:沿线滑动,还是把线推走
这是本文最想区分的一件事。
第一种:在前沿上滑动。
蒸馏、量化、MoE、KV cache、投机采样、prefill/decode 分离、模型路由——这些都在做同一件事:让你在已有的那条线上选到更好的位置。
有个很典型的数据:同样的 16 张 H100,把 prefill 和 decode 拆到不同的 GPU 组上,在固定延迟下能做到最高 2 倍的每卡吞吐。这是极好的工程,但它没有移动那条线,它只是让你在线上站得更靠前。
第二种:把整条线往外推。
新架构、新的 scaling 维度(比如把计算从训练时挪到推理时)、新的训练方法、新的芯片——这些会改变"什么叫做不到"这件事本身。
判断方法很简单:
问一句:它让我用同样的钱买到更多,还是让我买到了以前买不到的东西?
前者是滑动,后者是推进。两者都重要,但只有后者改变范式。
三、为什么必须同时推两条边界,而且它们互相喂养
一条前沿有两个端点,对应两种不同的雄心:
- 上边界(天花板):不计成本,最聪明能到哪
- 下边界(地板):一个够用的智能,最便宜能做到多少
很多人以为这是两个独立的方向,可以二选一。不是的,它们互相是对方的前提。
Jeff Dean 讲过一个容易被忽略的细节:Google 的 Flash 系列之所以能一代比一代强,靠的是把最强的模型蒸馏进小模型——你想让小模型更强,前提是你先有一个更强的大模型当老师。下一代 Flash 能达到甚至超过上一代 Pro,这个"跨代超越"不是凭空来的,是同一个技术栈里上端先顶上去、下端才被拽上来的。
反过来也一样:地板是天花板的市场。没有大规模部署,前沿模型的巨额成本摊不薄,上边界就顶不动。
所以只推一端会怎样:
- 只推天花板:前沿变陡。能力很强,但没人用得起——这正是现在发生在最强模型身上的事
- 只推地板:前沿变平。便宜是便宜了,但天花板不动,新类型的任务永远解锁不了
两条一起推,包出来的那块空间才真的变大。这就是"扩散开的前沿空间"真正的含义。
四、最反直觉的那个事实
现在可以解释开头那组打架的数字了。
同等智能的价格每年降 5–10 倍——这是地板在往下沉,也是整条线在往外走。
最强模型的运行成本每年涨 3–18 倍——这是天花板在往上顶,代价是推理时计算:让模型在给出答案前先想一大段,用更多 token 换更高的准确率。
于是前沿的真实形状不是平行外移,而是右端在抬高、左端在压低,中间的斜率在变。
这个形状变化本身就是信息:最右侧那段变陡,说明"再往上挤一点准确率"的代价正在急剧上升。这对做产品的人是个提醒——你为了最后那几个百分点付的钱,可能比前面所有百分点加起来还多。
五、关键机制:便宜一点点,为什么会解锁一整类应用
这是我认为最被低估的一点。
前沿往外挪一点点,新打开的不是一小段线,而是一整块面积。
因为每一个具体应用,在前沿图上只需要一个点的位置:它需要"智能 ≥ Q",且"单次成本 ≤ C"。在前沿越过这个点之前,这个应用是不存在的——不是贵,是算不过账,所以它从来没被认真想过。
一旦越过,它是从 0 到 1,不是从 1 到 1.1。
有个特别好的实证。有研究者要判断一万篇论文里哪些真正复用了某个数据集,需要让模型把论文全读一遍:
| 时间 | 同样智能水平的全量扫描 |
|---|---|
| 一年前 | 无论花多少钱都做不到 |
| 今年 3 月 | 数千美元 → 只能抽样做试点 |
| 现在 | 一百美元出头 → 全量普查 |
注意最后一档的变化:它不只是变便宜了,它换了一个做法。从抽样试点变成全量普查,结论的性质都变了——抽样只能说"大概有多少",普查能给出确定答案。
这就是前沿外移真正兑现的方式:不是让旧做法省钱,而是让新做法第一次成立。
一组更硬的数字在旁边佐证:按 Artificial Analysis 对 137 个模型的实测追踪,某个固定任务上达到同等智能水平的成本,半年内从 1.22 美元降到 0.022 美元,降了 56 倍;各能力档位的最低成本大约每 4 到 10 周减半,而且降价速度还在加快。
六、地板解锁规模,天花板解锁新任务
前沿的两端,解锁的东西不一样:
- 天花板往上顶 → 解锁新类型的任务。以前没有任何模型能做的事,现在有了
- 地板往下沉 → 解锁规模。大量有用的工作不需要最聪明的模型,只需要一个"够好"的模型被调用一万次
而这里有个反常识的数据:降价最快的恰恰是最高能力档。同一份研究里,GPQA-Diamond 最高分段的价格每年降 31 倍,而最低分段只降 1.7 倍。
这意味着什么?高智能正在变成大宗商品。
对你的直接含义是:如果你的产品现在因为"太贵"而用不起最强的模型,这个障碍消失的速度,比你以为的快得多。别按今天的价格做长期架构决策。
七、两个容易踩的坑
坑一:别指望省钱。
这里有个绕不开的悖论——单位智能的价格暴跌,通常不会让总支出下降,反而会让它上升。因为便宜了以后,你会用它做以前根本不会考虑做的一万件事,用量涨得比降价快。
所以:不要按"以后会更便宜"来推迟现在该做的事;但也不要按现在的单价去估算未来的账单。这两句话不矛盾,它们说的是同一件事的两面。
坑二:真正的墙是物理的,不是算法的。
Jeff Dean 反复强调一件事:现代 AI 系统的瓶颈已经从 FLOPs 转向能量——以皮焦耳计。搬运数据的能耗比做一次乘法高出大约 1000 倍。
这解释了很多看起来奇怪的工程选择:batching 的本质是摊销数据搬运的能量开销,投机采样是用草稿模型摊掉加载权重的开销,稀疏化(万亿参数只激活 1%–5%)是在砍要搬的比特数。
前沿最终能推到哪,不由算法单独决定,由物理决定。这也是为什么硬件必须提前 2–6 年预测 workload 去做协同设计——等你看见前沿的形状时,能改变它的那颗芯片已经在两年前定案了。
八、怎么判断:是真推进,还是只是换了个位置
给你三个问题,每次看到"重大突破"时问一遍:
- 它移动的是前沿,还是只让我在前沿上换了个位置?
新的能力等级出现了,还是同样的能力变便宜了?
- 数量级是多少?
10 倍是范式,10% 是优化。别把渐进改良当成时代变化去下注。
- 有没有"以前不成立"的应用出现了?
这是最硬的标准。真正的推进一定会伴随新用例——不是老用例变便宜,而是出现以前根本不会有人去做的事。
顺带一个选模型的实用提醒:先想清楚你的 operating point,再去选技术。
同样是写代码,IDE 里的自动补全要的是"立刻出结果",延迟是硬约束;后台异步跑的代码审查要的是"质量够好、成本可控",时间可以放宽;而某些高价值场景愿意为多几个点的准确率付出巨大代价。
用户是不是在环上,彻底改变你的优化目标。先定这一点,再谈量化、RAG、推理时计算这些手段——它们各自作用在不同的约束上,选错了就是在优化一个没人关心的维度。
结尾
回到开头那句话:推动技术范式,需要同时推动这两条边界。
现在你应该能读出这句话的分量了——它不是在说"又要聪明又要便宜"这种正确的废话,而是在说一件有因果的事:
天花板是地板的老师(没有最强的模型,就没有下一代便宜的小模型),<br>地板是天花板的市场(没有大规模部署,前沿的成本摊不薄)。
两端互相喂养,前沿才整体往外走,包出来的空间才变大。
而那块新打开的空间里会长出什么,我们现在说不出来。
能确定的只有一件事——在门槛被跨过的那一刻之前,那些应用连名字都还没有。
就像一年前,没人会认真提议"把一万篇论文全读一遍"。不是因为它贵,是因为在那个价格上,它根本不作为一个选项存在。