 AIGC.promo
我让 AI 写了个只给自己用的 Markdown 阅读器
用 WorkBuddy 做了个零依赖单文件的本地 Markdown 阅读器。真正变化的不是写代码的速度。
我电脑里散着一堆 .md。
会议记录、方案草稿、读书笔记、临时写的脚本说明……它们有几个共同点:平铺在某个文件夹里,文件名看不出内容,想找一句话只能全局搜索碰运气。
给这种需求"立项"是荒谬的。没有用户、没有收益、不值得注册域名,也不值得为它学一个新框架。以前的处理方式只有两种:忍着,或者找个现成工具凑合,然后在某个不顺手的细节上继续忍着。
后来我在 WorkBuddy 里开了一个会话,把这个需求原原本本说了出来。
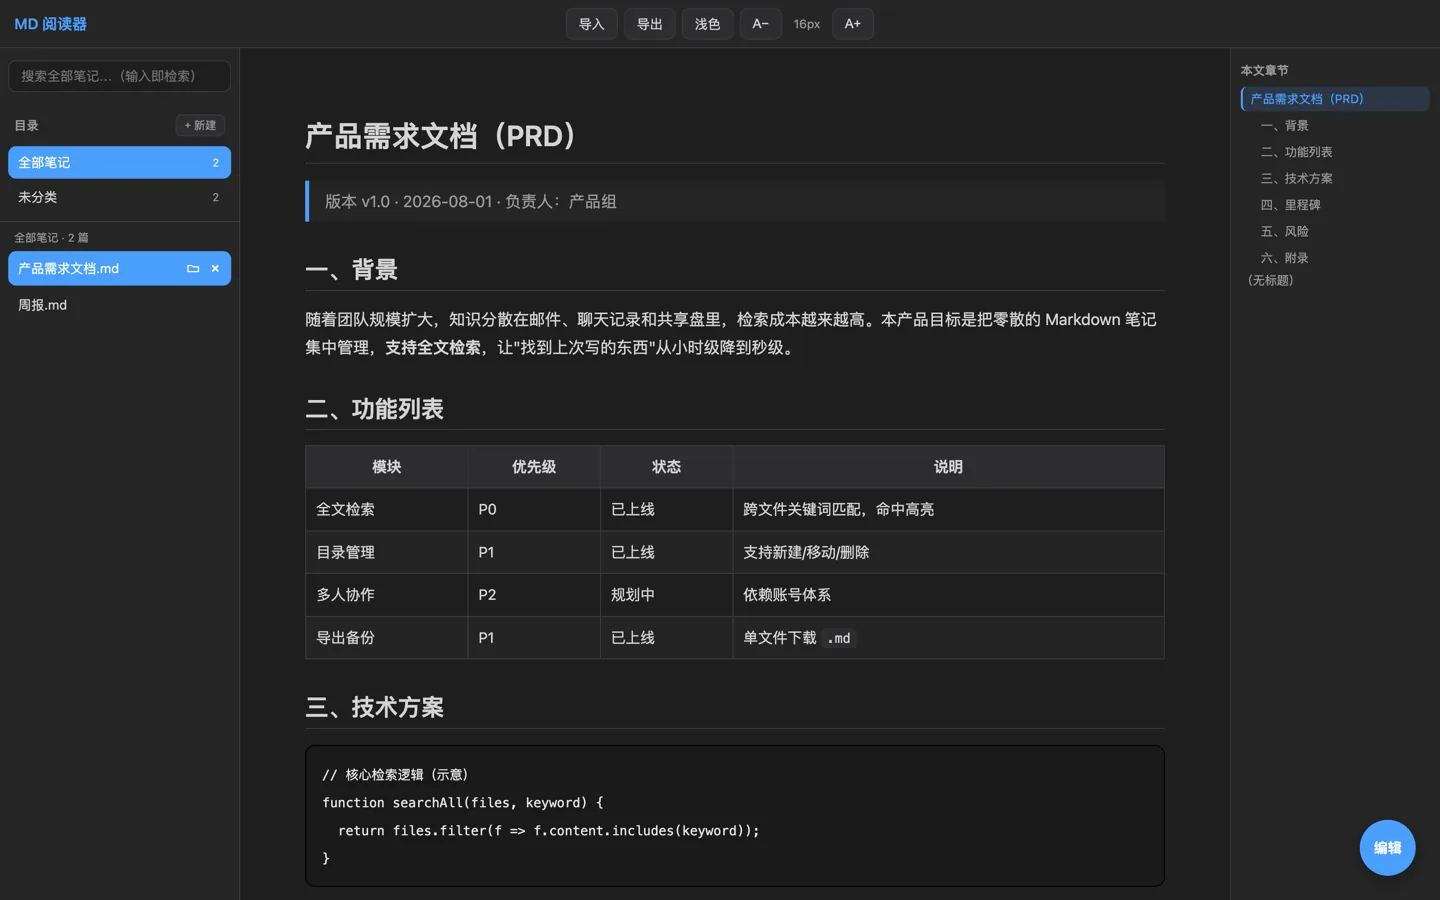
它现在长什么样
一个 index.html,77KB,双击就能用。没有 npm install,没有 CDN,断网照常跑。
- 左边目录和文件,中间正文,右边自动生成的章节锚点(标题少于两个的时候自己收起,不占地方)
- 导入:多选,或者把文件直接拖进窗口
- 虚拟目录:应用内的分类,跟你磁盘上的文件夹无关,可以拖拽归类
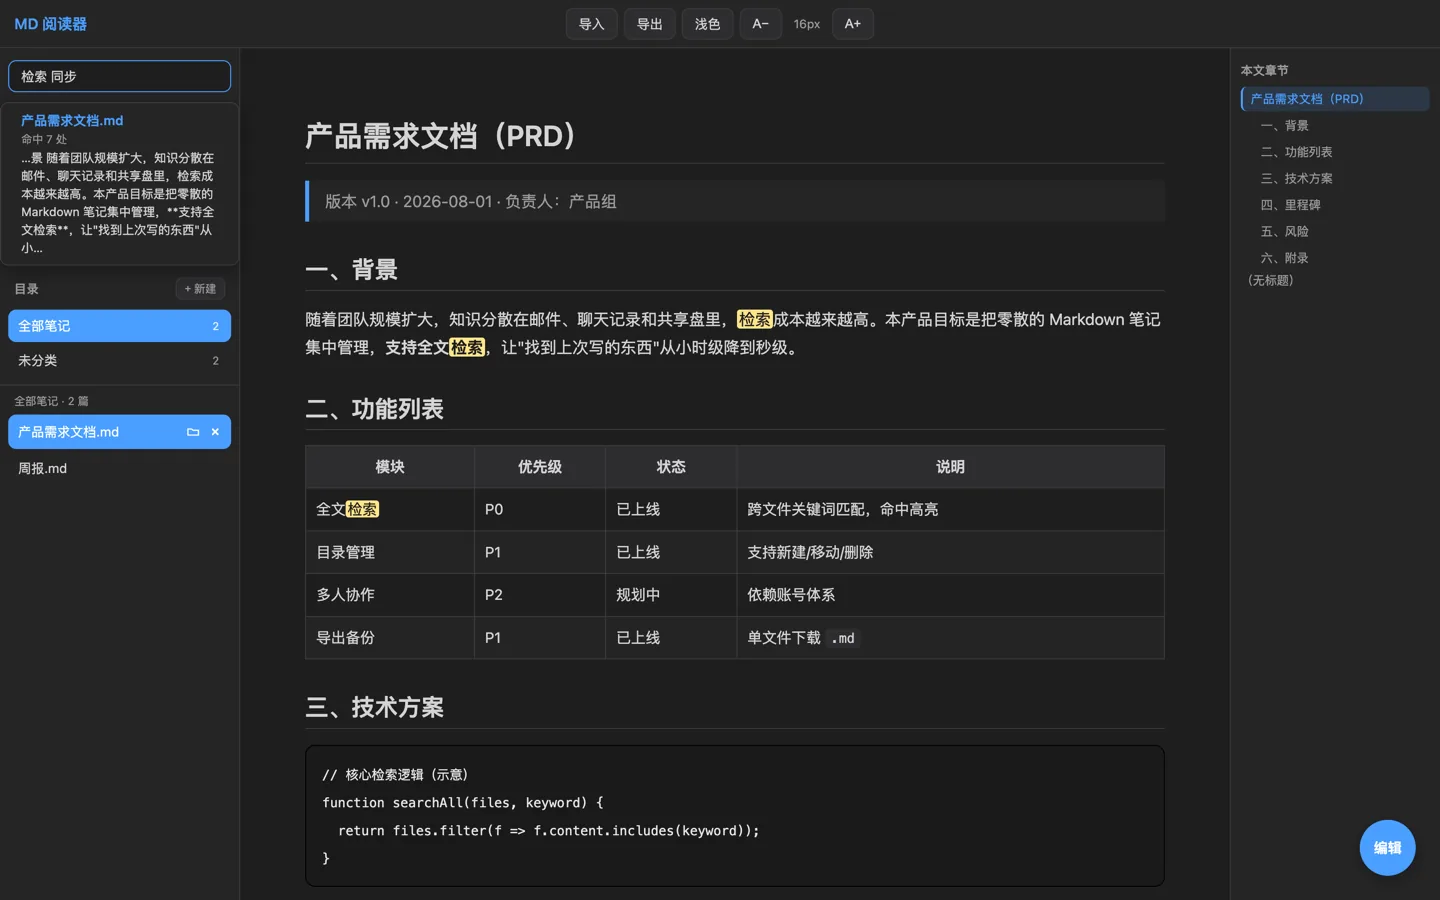
- 全文检索:空格分隔多个词是"全都命中",引号是精确短语,首尾加斜杠是正则。命中处高亮,点一条结果直接跳过去
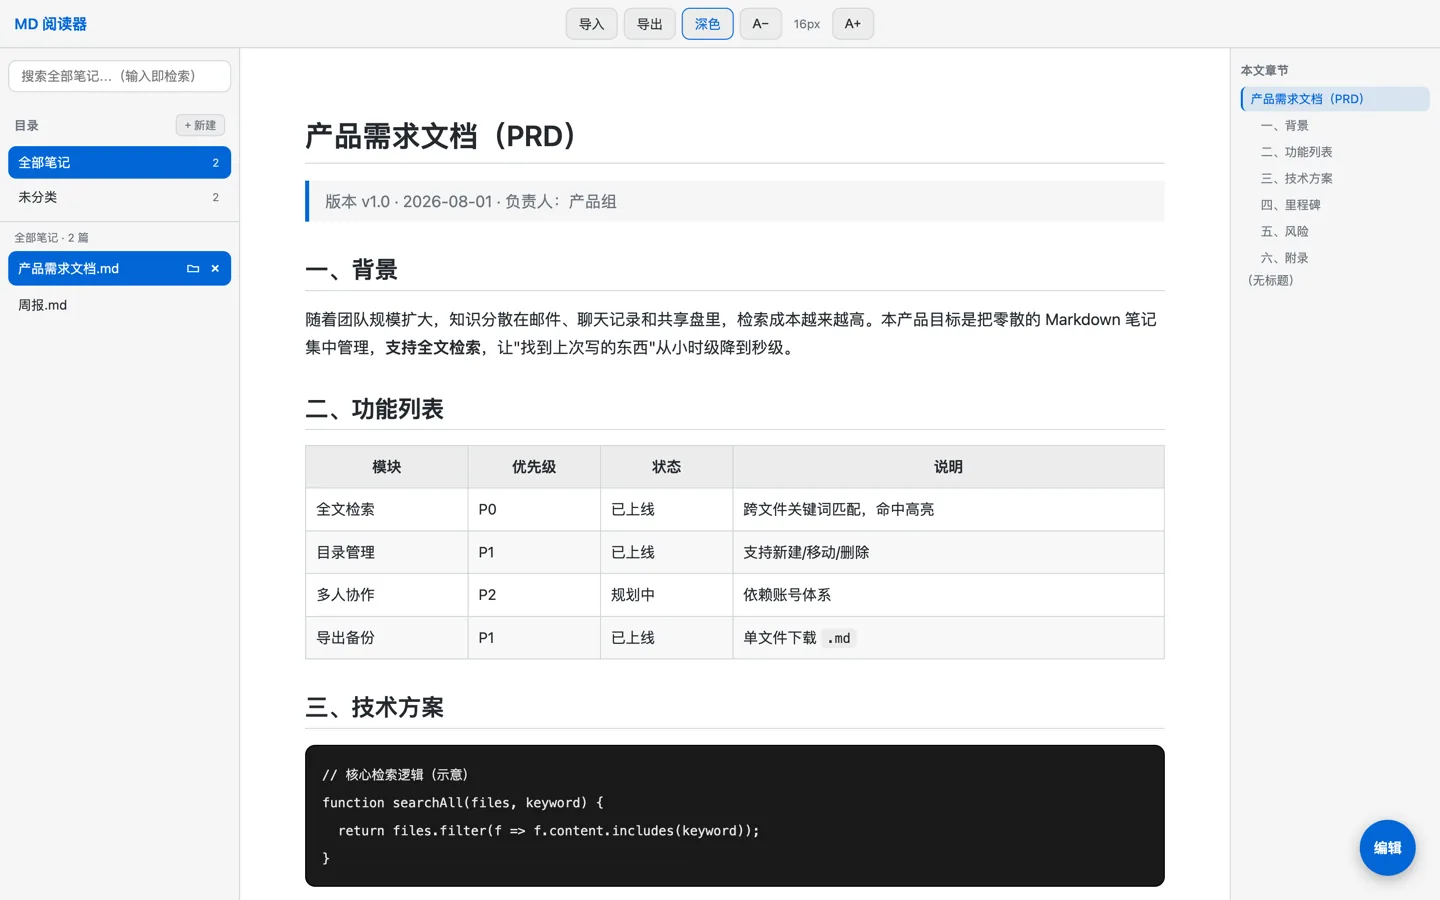
- 明暗双主题,字号一键调
- 编辑:右下角一个球,点进去是"所见即所得"和"源码"两种模式,Cmd+S 保存,Esc 放弃
- 数据全在 localStorage,没有任何东西离开这台电脑
先交代真实的投入
怕你们以为这是"一句话生成一个产品"的故事,先把账摊开。
第一个能用的版本,确实是第一天下午就有的。但从第一版到我真正满意用起来,前后跨了四天——8 月 18 日到 21 日,而且这四天里还夹着别的事。从当时的记录里数,留下痕迹的改动有二十来次,其中有三次值得一提:
第一次,它做错了方向。 编辑功能最早给的是源码文本框——能用,但不是我想要的。我说要在渲染好的正文里直接改,像改网页一样打字。整块推倒,改成所见即所得。
第二次,是我表达得不够准。 我说"要有目录",它做成了真实磁盘目录,还接了一套文件系统读写的 API。但我其实只要应用内的分类,跟磁盘毫无关系。又推倒了一次。
第三次,最典型:它说修好了,但没修好。 顶栏按钮在窄屏下中文被拆字换行,它改了一版宣布修复。第二天我截图一量,还在换行。真因是阻止中文折行需要两个 CSS 属性配合,缺一不可——它改了一个就宣布胜利。
所以准确的口径是:启动确实只要一个下午,但"能用"和"顺手"之间,隔着二十次你亲自验收的来回。
三条硬约束,我在第一句话里就定死了
写之前我跟它说清楚:单文件、零依赖、离线可用。
第三条尤其重要。这是个给自己用的东西,我不想哪天某个 CDN 挂了、某个包不维护了,它就打不开;也不想在飞机上、在断网的地方,看不了自己的笔记。
结果是连 Markdown 解析器都是手写的——一个逐行往下读的扫描器,标题、列表、代码块、表格、引用、行内代码、链接,加起来一百来行。没有 marked.js,没有 highlight.js。
这个选择在过去属于"成本高到不划算",现在变成了"多加一句话的事"。这是第一个让我重新算账的地方。
AI 真正替我省下的,不是写代码
是那些我想到了、但确定自己懒得写的部分。
一是 Markdown 的往返。
所见即所得编辑有个隐藏代价:改完还得变回 .md 源码——DOM 里有 h2、有 ul、有编辑器自己塞进来的 div,得逐一翻回 # 标题、- 列表项。逻辑不复杂,分支特别多,写起来纯耗耐心。我自己干这事,大概率会写一半去泡咖啡。
二是那种踩过才知道的坑。
举一个真实发生过的:Markdown 表格里如果出现一个字面竖线——比如代码里写了 |——整张表会在下一行突然散架,列数对不上,浏览器替你重排,看起来像玄学。这个 bug 是我拿真实文档喂进去才炸出来的,查了才发现解析器在无脑按竖线切列。修法是先用占位符把代码块里的竖线保护起来,只在真正该分列的地方切;导出时再转义回去。后来回归测试又揪出它的镜像 bug:序列化时忘了把竖线转义回来,编辑保存一次,表格再坏一次。一来一回才算真正闭环。
还有一个更凶的:搜索支持正则之后,a* 这种能匹配空串的正则会把它自己写的高亮循环锁死,页面直接冻结。这种 bug 不写自动化测试根本碰不到。
三是"用久了才会遇到"的问题。
localStorage 有容量上限,笔记攒多了写入会抛异常。第一版的处理很朴素:捕捉异常,降级成只存文件名。但"丢了内容、只留一个名字"其实挺绝望的——直到一次系统性评审把这个问题翻出来,才补上了后半段:列表上给超限的文件挂警示角标,点一下可以重新导入。最坏情况从"丢得不明不白"变成"丢得明明白白,且找得回来"。
但它不替你判断"要不要"
这一点反而最重要。
举两个还留在我界面上的例子:删除文件用的是浏览器原生 confirm,灰扑扑一个系统框,跟整体风格格格不入——因为新建、删除目录的弹窗是我后来提的需求,都是自绘的,唯独这个删除按钮是第一版就有的,没人觉得它有问题。还有:每次打开页面都弹一次使用说明,第一次是体贴,第三十次是打扰。
功能是分块长出来的,前后一致性没有人为你兜底;"说修好了"和"修好了"之间,隔着一层你自己的眼睛。
它负责把你要的东西做出来,做到什么程度取决于你描述得多细。它不负责替你想"A 和 B 是不是该长一样",也不负责在宣布胜利之前再看一眼截图。
所以真正变的是什么
不是写代码的速度。
是那条线往下挪了一截:从"值不值得立项",挪到了"值不值得开个会话"。
以前我脑子里有个清单,装着一堆"想要但算了"的小东西——给某个内部页面做个只看自己的视图、把某份整理好的表格自动变成周报、给某个重复操作写个小界面。它们每一个都不值得立项,但每一个都让我每天别扭几分钟。
现在这个清单在缩短。因为启动成本从"半天起步,还得纠结技术选型",变成了"描述清楚需求,然后盯着看它是否符合预期"。
还有一个不那么显眼的好处:这东西完全是我的。 数据在我本机,源码我读得懂,想加功能就加,不用跟谁提需求,也不会有朝一日因为某个服务下线而失效。这种所有权感,用 SaaS 是找不回来的。
做开发的人可能体会更深:我们花了太多时间在做"值得被做完"的东西上,而不是"我自己真的需要"的东西上。
如果你想试,我总结了几条
- 拿自己真实的需求当第一个项目。 不要拿 Todo List 练手。找一个你真的天天用、真的被烦到的东西——验收标准会自动变成"我用着顺不顺",而不是"功能全不全"。
- 开头就把约束说死。 单文件、零依赖、不用什么框架、跑在什么环境。约束越具体,返工越少。
- 一次只提一个改动,改完必须亲眼验收。 一口气说十个需求,你会得到十个都对的功能和一个整体别扭的界面。它说"修好了"不算数,截图才算数。
- 读一遍它写的代码。 读不懂的地方让它加注释,或者让它解释为什么这么写。这一步花的时间,会在你第三次想改它的时候连本带利还回来。
- 功能多了之后,让改动跑回归。 我们后来每次改动都过同一套十几步的自动化检查,就是为了防止修一个东西碰坏三个旧的。
最后:它不是一个完美的工具,也没打算往完美的方向做。它是我这台电脑上一个趁手的、谁也拿不走的东西。
网址都不需要——它就在我硬盘里。