三步装好、四个业态照抄、两个真跑通的案例。
全程只讲「你该说什么、它会交回什么」,不吹能力。
本页含推广链接:通过页面内链接注册,作者会获得积分奖励。以下工具用法均按实际体验写,没跑通过的不写。
.xlsx / .docx / .md / .html——能直接发出去的那种。
这三步只讲最低限度。基础操作官方自己会教、界面也会改,这里只留不容易变的东西:第一个任务该怎么选、怎么提。
.xlsx。列得出来,说明文件读写这条链路通了。选题只有一条原则:拿自己真实的需求当第一个项目,不要拿 Todo List 练手。找一个你天天用、真的被烦到的东西——验收标准会自动变成「我用着顺不顺」,而不是「功能全不全」。
最适合当第一个任务的形态是:把一堆散的东西收成一张表。输入确定、输出可数、对错一目了然。
读 ~/Downloads/外卖评价-9月.csv。
按「菜品口味 / 出餐速度 / 服务态度 / 包装配送」四类给每条差评打标签,
输出 issue_summary.xlsx:
  sheet1 = 按类别聚合的条数与占比
  sheet2 = 每类的高频原话 top5 + 一版回复话术
不要改动原始文件,也不要自己编数据;归类不进这四类的放进「其他」。你会拿到:一张能直接发给店长的归因表,附带现成回复话术。
| 能力 | 什么时候用它 | 一句话示例 |
|---|---|---|
| 读写本地文件 | 批量整理类需求的主战场。它直接读你的表格和文档,交付的也是文件。 | 把 50 份周报 md 里的「下周计划」段落抽出来,合成一张表。 |
| 跑脚本做自动化 | 需要批处理、抓数据、转格式、调接口时,它会自己写 Python / Node 跑。 | 写个脚本把这 200 张图压到 200KB 以内,保留 webp。 |
| 自定义 skill | 同一条流程要跑第二遍时,把它固化下来,下次一句话触发。 | 以后我说「抓公众号」,就按这个 skill 跑。 |
第三件最容易被忽略,也最值钱。一个 skill 就是把跑通过的流程写成一个带说明的 Markdown 文件,开头几行长这样(这是一份真跑过 72 篇的活样本):
---
name: wechat-mp-scraper
description: 批量抓取微信公众号某公众号的系列/全部文章正文并转 Markdown。
             当用户要「把某个公众号的文章薅下来」时使用。
agent_created: true
---

# 微信公众号文章批量抓取

## 何时用
用户要导出 / 存档某个公众号的文章。不要一开始就上浏览器——
先用下面的接口链路,通常 10 分钟内能拿全。
关键在 description 那句:它决定了什么时候会被自动触发。写清楚「用户会怎么说」,比写清楚「这个 skill 做了什么」更重要。
每段都是同一个结构:典型痛点 → 怎么干 → 三句能直接复制的话。把文件名换成你自己的,其余照发。提示词均为示例,表头跟你实际文件不一致时按需调整。
平台后台导出的 CSV 直接丢给它。它能一次性干三件事:把差评按归因分类并配回复话术、把流水表变成能交的周报、把菜单里的价格批量改掉并附改动清单。你不需要先学它的语法,说清「读哪个文件、输出什么表、不许动原文件」就够。
读 ~/Downloads/外卖评价-9月.csv。
按「菜品口味 / 出餐速度 / 服务态度 / 包装配送」四类给每条差评打标签,
输出 issue_summary.xlsx:
  sheet1 = 按类别聚合的条数与占比
  sheet2 = 每类的高频原话 top5 + 一版回复话术
不要改动原始文件,也不要自己编数据。你会拿到:一张能直接发给店长的归因表,附带现成回复话术。
读 门店日流水.xlsx 的「9月」sheet,和「8月最后一周」对比:
营业额、客单价、订单数、外卖占比。
涨跌原因只能引用表内数据,不许推测。
生成 周报.md,末尾附 3 条下周动作(每条写清依据哪一列)。你会拿到:一份能直接交的周报,每个数字都有出处。
把 menu.docx 正文表格「价格」列全部 +1 元,
另存为 menu-v2.docx,不要覆盖原文件,
并给一份改动清单(品名 / 原价 / 新价)。你会拿到:新菜单 + 一张改动清单,方便你复核有没有漏改。
盘点差异让它自动排序并给疑似原因、沉睡老客让它分层并写召回文案、促销方案让它一次出几套带成本口径的对比。这类活共同点是「规则清楚、数据在你手上」,正是它最擅长的部分。
inventory.xlsx 里「实盘数」不等于「系统数」的行挑出来,
按差异金额降序,输出 diff.xlsx。
对差异大于 10 件的 SKU,给一行可能原因(漏扫 / 串码 / 损耗)。你会拿到:按钱数排序的差异表,先看最贵的那几行。
会员消费.csv 里,近 90 天未复购、但历史消费大于等于 3 次的老客挑出来,
输出 winback.xlsx(手机号后四位 / 上次消费日 / 累计金额 / 常买品类),
并写两条不同语气的 100 字短信文案。你会拿到:一张可导入的召回名单 + 两条能直接发的短信。
国庆促销,社区店客单价 80 元。
出 3 套方案:满减 / 第二件半价 / 会员日。
每套写清规则、成本测算口径、以及拉新和拉客单之间的取舍。
输出 promo-plan.md。你会拿到:三套带成本口径的方案,选完就能执行。
参数表批量生成 listing、价格表出监控与趋势、差评分类后同时给客服话术和是否要追供应链的判断。第三件事尤其值得做——差评是最便宜的产品反馈,只是没人有空读。
按 商品参数.xlsx 每行生成:
  标题 30 字以内(核心词 + 属性词,不堆砌)
  5 条卖点,每条 20 字以内
  详情 200 字
输出 listing.xlsx,一行一个商品,三列。
禁用「最」「第一」「顶级」等极限词。你会拿到:一张能直接交给运营上新的表,且已规避极限词。
竞品价格.csv(日期 / 店铺 / SKU / 到手价):
算每个 SKU 近 30 天的价格区间和降价次数,
标出降价大于等于 3 次的,
输出 price-watch.xlsx,外加一段文字趋势说明。你会拿到:一张价格监控表 + 一段能直接念给老板的趋势。
评价.csv 里只挑差评,按 质量 / 物流 / 尺码 / 描述不符 分类。
每类给:占比、代表原话 3 条、客服回复模板 2 条、
以及是否需要反馈供应链(是 / 否 + 理由)。你会拿到:一份差评分类报告,附话术和「要不要追供应链」的判断。
用你自己的历史文章反推选题库、一次出多平台版本、把推送流程固化成一句话触发。第三件事我们已经跑通了,就在下面案例 2,脚本和踩坑记录都在。
读 素材/ 下最近 20 篇 md,
总结我写得最多的 3 类选题与平均结构,
输出 topics.xlsx:10 个新选题
(标题 / 一句话角度 / 需补的事实 / 1500 字够不够)。你会拿到:一份从你自己历史里长出来的选题库,不是通用爆款模板。
draft.md 改小红书版:标题 20 字内带数字、正文 600 字内、
每 3 行一换行、末尾 5 个标签,存 xhs.md。
再改知乎版:1500 字,开头先给结论,存 zhihu.md。你会拿到:两个平台各自能直接发的版本。
把「读 md → 转内联样式 HTML → 推公众号草稿箱 → 回写站点 articles.js」
这条流程固化成一个 skill,写进我自己的 skill 目录,
正文里记上踩过的坑(哪些接口不能混用、IP 白名单的顺序)。你会拿到:以后一句话触发整条流程,坑不用踩第二遍。
两个案例的数字和坑都来自实际记录,没有一个是编的。第一个讲「它能做成什么」,第二个讲「它能替你省下什么」。
一个单文件 HTML,双击就能打开,断网照常跑。里面预置了近百篇存档文章和配图,不用拖文件夹、不用起服务。
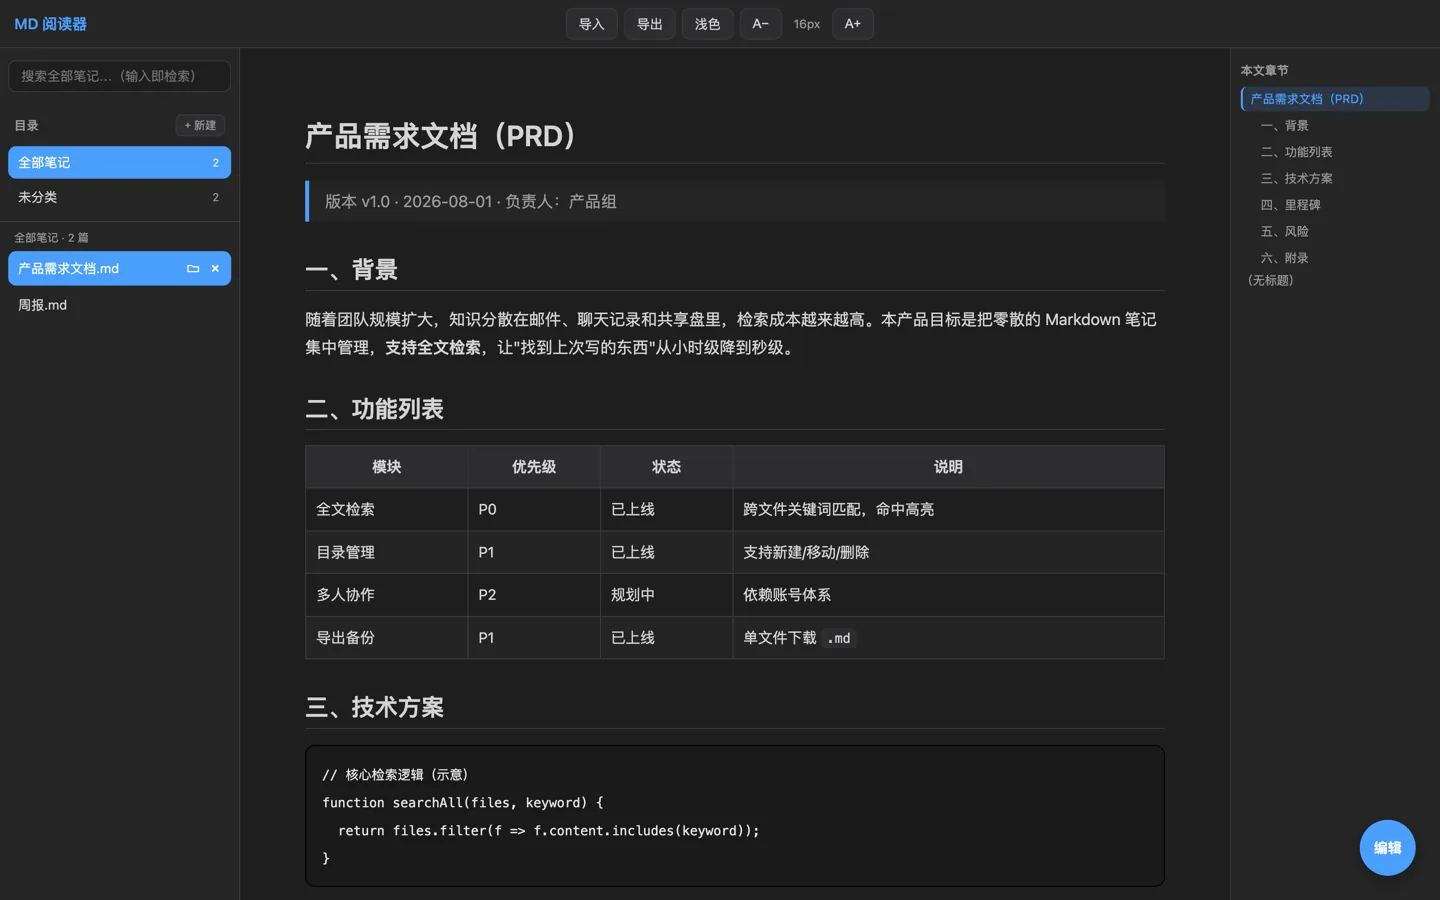
写一篇稿子最烦的不是写,是写完之后的排版和上传。这条链路把它压成了一条命令:Markdown 进去,草稿箱里躺着一篇排版完整的图文。
| 步 | 接口 | 干什么 | 关键产出 |
|---|---|---|---|
| 1 | stable_token | 取 access_token | token,本地缓存 2 小时 |
| 2 | media/uploadimg | 上传正文配图 | 换成 mmbiz.qpic.cn 的 URL |
| 3 | material/add_material | 上传封面为永久素材 | thumb_media_id |
| 4 | draft/add | 建草稿 | 草稿箱里那篇 |
add_material 返回的 url 放进正文会被微信过滤掉,只有 uploadimg 的 url 能用;反过来,封面必须是永久素材的 media_id,临时素材 ID 不行。DRY=1 node publish.mjs # 只生成并检查正文,不调任何接口
WX_APPID=你的AppID WX_SECRET=你的AppSecret node publish.mjs凭证不落盘,只走环境变量。空跑那一步主要看正文切得对不对、图片有没有漏。
意外收获是最后一步:推完草稿,脚本会自动往站点首页的文章数据里追加一条,「最近文章」的卡片自己就出现了。写、发、上站是一条线,不用在三个地方各改一次。
说句实话:这条线跑通花了两个晚上,其中一个晚上在跟验证码和图片接口较劲。但跑通之后,每篇文章省下来的是 40 分钟排版。
注册领 2000 积分,然后从一个你真的被烦到的任务开始。
别拿 Todo List 练手。
含推广链接:通过本页链接注册,作者会获得积分奖励。以上案例均为实际使用记录。